
TRENDING TAGS :
DNA Test Explained in Hindi: डीएनए टेस्टिंग कैसे काम करती है, इनमें क्या स्टोरेज होता है?
DNA Test Explained in Hindi: डीएनए टेस्टिंग में पूरे जीनोम की जगह खास आनुवंशिक हिस्सों की जांच कैसे होती है?
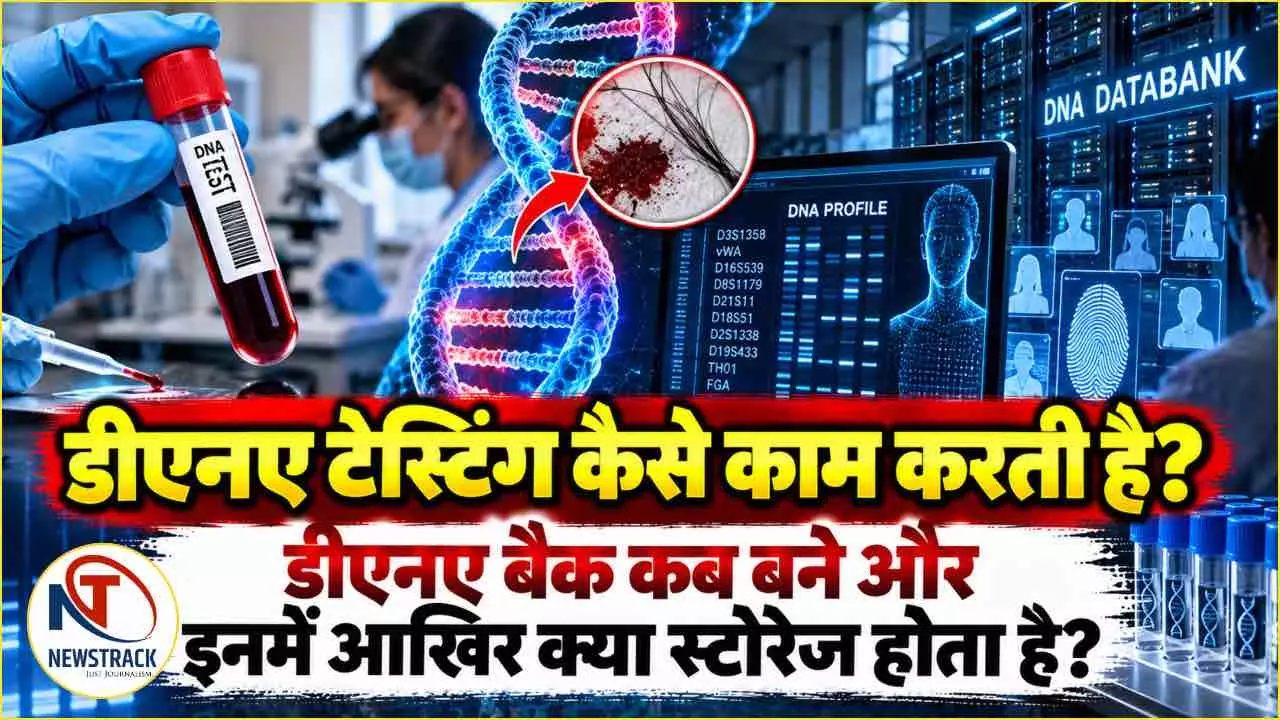
How DNA Testing Works DNA Test Explained in Hindi
DNA Test Explained in Hindi: किसी अपराध की जगह से मिला खून का एक छोटा सा धब्बा, बाल की जड़, त्वचा की कुछ कोशिकाएं, लार या किसी वस्तु पर छूने से बची कोशिकाएं जांचकर्ताओं के लिए बेहद महत्वपूर्ण हो सकती हैं। इन चीजों में मौजूद डीएनए किसी व्यक्ति तक पहुंचने का रास्ता खोल सकता है। लेकिन यहां एक दिलचस्प सवाल है। जब किसी व्यक्ति का डीएनए इतना विशाल और जटिल है, तो प्रयोगशाला आखिर इसकी जांच कैसे करती है? क्या वैज्ञानिक हर व्यक्ति का पूरा डीएनए पढ़ते हैं? और अगर लाखों लोगों के डीएनए रिकॉर्ड रखने हों तो उन्हें कैसे संभाला जाता है?
असल में डीएनए जांच का सबसे महत्वपूर्ण हिस्सा पूरा डीएनए पढ़ना नहीं, बल्कि उसके भीतर मौजूद कुछ खास जगहों को पहचानना है। इन जगहों पर मौजूद छोटे-छोटे आनुवंशिक अंतर व्यक्ति की पहचान के लिए बहुत उपयोगी होते हैं। इन्हीं से एक डीएनए प्रोफाइल बनाई जाती है, जिसे बाद में किसी दूसरे नमूने से मिलाया जा सकता है।
डीएनए आखिर है क्या?
डीएनए हमारे शरीर की कोशिकाओं में मौजूद वह अणु है जिसमें आनुवंशिक जानकारी दर्ज होती है। इसे आप शरीर की जैविक निर्देश-पुस्तिका की तरह समझ सकते हैं। आंखों का रंग, बालों की कई विशेषताएं, शरीर की संरचना और बहुत सी जैविक प्रक्रियाओं से जुड़ी जानकारी डीएनए में मौजूद होती है।
लेकिन हर व्यक्ति का डीएनए पूरी तरह अलग नहीं होता। इंसानों के डीएनए का बहुत बड़ा हिस्सा एक जैसा है। फर्क उन जगहों पर ज्यादा उपयोगी होता है जहां लोगों के बीच आनुवंशिक विविधता होती है। फॉरेंसिक जांच में इन्हीं अलग-अलग हिस्सों को निशाना बनाया जाता है।
यही वजह है कि किसी व्यक्ति की पहचान के लिए उसका पूरा आनुवंशिक नक्शा पढ़ने की जरूरत नहीं पड़ती। वैज्ञानिक डीएनए के चुनिंदा हिस्सों से ऐसा प्रोफाइल तैयार कर सकते हैं जिसकी दूसरे व्यक्ति के प्रोफाइल से तुलना की जा सके।
डीएनए टेस्ट की शुरुआत कहां से होती है?
सबसे पहले किसी स्रोत से डीएनए वाला नमूना लिया जाता है। यह खून, लार, वीर्य, त्वचा की कोशिकाओं, बाल की जड़ या किसी अन्य जैविक सामग्री से मिल सकता है। अपराध की जगह से मिला नमूना अक्सर बहुत छोटा, पुराना या किसी दूसरे व्यक्ति की कोशिकाओं के साथ मिला हुआ भी हो सकता है। प्रयोगशाला में सबसे पहले यह देखा जाता है कि नमूने में डीएनए मौजूद है या नहीं और उसकी मात्रा तथा गुणवत्ता कैसी है। इसके बाद डीएनए को कोशिकीय सामग्री से अलग किया जाता है। यहीं से असली वैज्ञानिक प्रक्रिया शुरू होती है।
बहुत कम डीएनए को लाखों प्रतियों में कैसे बदला जाता है?
कई फॉरेंसिक जांचों में डीएनए की मात्रा बहुत कम होती है। ऐसे में वैज्ञानिक पीसीआर यानी Polymerase Chain Reaction तकनीक का इस्तेमाल करते हैं। इसे आसान भाषा में डीएनए की किसी खास जगह की बहुत सारी प्रतियां बनाने की मशीन समझ सकते हैं। मान लीजिए किसी नमूने में डीएनए का वह हिस्सा बेहद कम मात्रा में है जिसे वैज्ञानिक देखना चाहते हैं। पीसीआर उस चुने हुए हिस्से की बार-बार नकल बनाता है। इससे इतनी मात्रा तैयार हो सकती है कि मशीन उसका विश्लेषण कर सके। डीएनए तकनीक के इतिहास में पीसीआर का विकास एक बड़ा मोड़ था। अमेरिकी नेशनल इंस्टीट्यूट ऑफ जस्टिस की डीएनए टाइमलाइन के अनुसार पीसीआर 1983 में विकसित हुई और इसके बाद डीएनए प्रोफाइलिंग को बहुत छोटे नमूनों से करना आसान हुआ।
फिर डीएनए की पहचान कैसे बनती है?
फॉरेंसिक डीएनए जांच में अक्सर एसटीआर यानी Short Tandem Repeats देखे जाते हैं। ये डीएनए के ऐसे छोटे हिस्से हैं जहां कुछ अक्षरों का क्रम बार-बार दोहराया जाता है। अलग-अलग लोगों में इन दोहरावों की संख्या अलग हो सकती है। इसे ऐसे समझिए कि किसी व्यक्ति के डीएनए में कुछ जगहों पर एक खास क्रम 8 बार दोहराया गया है, जबकि किसी दूसरे व्यक्ति में वही क्रम 11 बार दोहराया गया हो। ऐसी कई जगहों की जानकारी को एक साथ देखने पर व्यक्ति का डीएनए प्रोफाइल बनता है।
इस प्रोफाइल को पूरा डीएनए नहीं समझना चाहिए। यह डीएनए के चुने हुए पहचान वाले हिस्सों से बनी एक तरह की संख्यात्मक पहचान है। एफबीआई के अनुसार अमेरिका के सीओडीआईएस तंत्र में फॉरेंसिक एसटीआर प्रोफाइल को चुने गए कोर स्थानों पर मौजूद एलील की जानकारी के रूप में दर्ज किया जाता है। यानी डेटाबैंक में आम तौर पर किसी व्यक्ति का पूरा डीएनए अनुक्रम जमा करके नहीं रखा जाता। पहचान के लिए जरूरी चुने हुए हिस्सों की प्रोफाइल रखी जाती है।
डीएनए मैच का मतलब क्या होता है?
अब मान लीजिए किसी अपराध की जगह से मिला खून किसी अज्ञात व्यक्ति का है। प्रयोगशाला उससे डीएनए प्रोफाइल तैयार करती है। इसके बाद उस प्रोफाइल की तुलना किसी संदिग्ध व्यक्ति के नमूने से की जा सकती है। अगर दोनों प्रोफाइल में जांचे गए सभी महत्वपूर्ण स्थानों पर अपेक्षित समानता मिलती है, तो वैज्ञानिक इसे मैच के रूप में देखते हैं। लेकिन इसका मतलब यह नहीं कि कंप्यूटर ने केवल एक बटन दबाकर अपराधी घोषित कर दिया। मैच मिलने के बाद प्रयोगशाला में उसकी पुष्टि की जाती है। नमूने की गुणवत्ता, प्रोफाइल की व्याख्या, संभावित मिश्रित डीएनए और अन्य वैज्ञानिक पहलुओं को देखा जाता है। एफबीआई के अनुसार डेटाबेस में मिलने वाले संभावित मैच की प्रयोगशाला के विशेषज्ञों द्वारा पुष्टि या खंडन किया जाता है। इसलिए डीएनए डेटाबैंक किसी व्यक्ति को अपने आप अपराधी साबित नहीं करता। वह जांच को किसी व्यक्ति तक पहुंचाने वाला महत्वपूर्ण वैज्ञानिक सुराग देता है।
डीएनए डेटाबैंक की जरूरत क्यों पड़ी?
अब यहां से कहानी और रोचक हो जाती है। अगर अपराध की जगह से डीएनए मिला लेकिन पुलिस के पास कोई संदिग्ध नहीं है, तो उस प्रोफाइल का क्या किया जाए? यहीं डीएनए डेटाबैंक काम आता है। एक डेटाबैंक में अलग-अलग मामलों या कानूनी श्रेणियों से तैयार डीएनए प्रोफाइल रखी जा सकती हैं। अपराध की जगह से मिले अज्ञात डीएनए को इन प्रोफाइल से मिलाया जा सकता है। अगर मैच मिलता है तो जांचकर्ताओं को नया सुराग मिल सकता है।
दूसरा फायदा यह है कि दो अलग-अलग अपराध स्थलों से मिले डीएनए प्रोफाइल आपस में मैच कर सकते हैं। तब यह पता चल सकता है कि दोनों घटनाओं में जैविक रूप से एक ही व्यक्ति से जुड़ा नमूना मिला था, भले ही उस समय जांचकर्ताओं को यह संबंध पता न रहा हो। अमेरिकी न्याय विभाग के अनुसार सीओडीआईएस का एक उद्देश्य अपराध स्थल की प्रोफाइल को ज्ञात प्रोफाइल से मिलाने के साथ-साथ अलग-अलग अपराध स्थलों को आपस में जोड़ना भी है।
दुनिया का पहला बड़ा राष्ट्रीय डीएनए डेटाबैंक कब बना?
आधुनिक राष्ट्रीय डीएनए डेटाबैंक की कहानी में ब्रिटेन का नाम बहुत महत्वपूर्ण है। इंग्लैंड और वेल्स ने 1995 में अपना National DNA Database शुरू किया। अमेरिकी नेशनल इंस्टीट्यूट ऑफ जस्टिस के अनुसार यह अप्रैल 1995 में शुरू हुआ और फॉरेंसिक डीएनए के बड़े पैमाने पर इस्तेमाल का महत्वपूर्ण पड़ाव बना। अमेरिका में भी इसी दौर में राष्ट्रीय स्तर पर व्यवस्था विकसित हुई। एफबीआई ने 1990 में सीओडीआईएस का शुरुआती परीक्षण शुरू किया। 1994 के DNA Identification Act ने राष्ट्रीय डीएनए इंडेक्स स्थापित करने का कानूनी आधार दिया और 1998 में National DNA Index System यानी NDIS पूरी तरह काम करने लगा। शुरुआत में इसमें नौ राज्य शामिल थे। इसका मतलब यह है कि डीएनए डेटाबैंक कोई बहुत पुरानी व्यवस्था नहीं है। डीएनए की खोज और उसकी वैज्ञानिक समझ 19वीं और 20वीं सदी में विकसित हुई, लेकिन अपराध जांच के लिए बड़े स्तर पर डिजिटल डीएनए प्रोफाइलों को जमा करके खोजने का दौर मुख्य रूप से 1990 के दशक में शुरू हुआ।
डेटाबैंक में आखिर रखा क्या जाता है?
यह सवाल सबसे महत्वपूर्ण है क्योंकि आम धारणा यह होती है कि डेटाबैंक में किसी व्यक्ति का पूरा डीएनए जमा रहता होगा। ऐसा जरूरी नहीं है। उदाहरण के लिए अमेरिका के NDIS में मुख्य रूप से डीएनए प्रोफाइल और उससे जुड़ी सीमित प्रशासनिक जानकारी रखी जाती है। एफबीआई के अनुसार CODIS में नाम, सामाजिक सुरक्षा नंबर या जन्मतिथि जैसे व्यक्तिगत पहचान विवरण सामान्य offender profiles के साथ सीधे प्रोफाइल के रूप में नहीं रखे जाते। वहां डीएनए प्रोफाइल, नमूना पहचान संख्या, संबंधित एजेंसी की पहचान और डीएनए विश्लेषण से जुड़े प्रयोगशाला कर्मियों की जानकारी जैसी चीजें रहती हैं। इस व्यवस्था का एक कारण गोपनीयता भी है। डेटाबैंक में मौजूद संख्यात्मक डीएनए प्रोफाइल को सीधे किसी नाम से जोड़ने की प्रक्रिया अलग रखी जा सकती है। जब किसी प्रोफाइल का मैच मिलता है, तब संबंधित एजेंसी कानूनी और प्रयोगशाला प्रक्रियाओं के तहत उस प्रोफाइल से जुड़े व्यक्ति की पहचान तक पहुंचती है।
क्या डेटाबैंक में आपकी बीमारी, रंग या पूरा आनुवंशिक भविष्य भी लिखा होता है?
फॉरेंसिक डेटाबैंक और जीनोमिक स्वास्थ्य जांच को एक ही चीज समझना गलत होगा। किसी व्यक्ति का पूरा जीनोम बहुत बड़ी मात्रा में जैविक जानकारी रखता है। उसमें बीमारी से जुड़े आनुवंशिक बदलाव, वंश से संबंधित जानकारी और शरीर की कई जैविक विशेषताओं से जुड़ी बातें हो सकती हैं। लेकिन फॉरेंसिक पहचान के लिए इस्तेमाल होने वाली एसटीआर प्रोफाइल का उद्देश्य मुख्य रूप से पहचान करना होता है। यही अंतर डीएनए डेटाबैंक को समझने में बेहद जरूरी है। डेटाबैंक में मौजूद एक फॉरेंसिक प्रोफाइल को किसी व्यक्ति का पूरा आनुवंशिक परिचय समझ लेना सही नहीं होगा।
भारत में क्या राष्ट्रीय डीएनए डेटाबैंक है?
भारत में डीएनए फॉरेंसिक जांच की क्षमता लगातार विकसित हुई है। गृह मंत्रालय के अनुसार 2018 से राज्यों की फॉरेंसिक विज्ञान प्रयोगशालाओं में डीएनए और साइबर फॉरेंसिक क्षमता मजबूत करने के लिए योजनाएं चल रही हैं और राज्य स्तर की प्रयोगशालाओं में डीएनए सुविधाओं को उन्नत किया गया है।
भारत में एक राष्ट्रीय डीएनए डेटाबैंक बनाने का प्रस्ताव भी कई साल पहले सामने आया था। DNA Technology (Use and Application) Regulation Bill में National DNA Data Bank और Regional DNA Data Banks की व्यवस्था प्रस्तावित की गई थी। प्रस्तावित ढांचे में अपराध स्थल, संदिग्ध या विचाराधीन कैदी, दोषसिद्ध व्यक्ति, लापता लोग और अज्ञात मृत व्यक्तियों से जुड़े अलग-अलग सूचकांक रखने की बात थी। लेकिन यहां एक महत्वपूर्ण कानूनी तथ्य है। 2019 वाला DNA Technology Regulation Bill 24 जुलाई 2023 को लोकसभा से वापस ले लिया गया। इसलिए उस प्रस्तावित कानून को आज लागू राष्ट्रीय डीएनए डेटाबैंक की कानूनी व्यवस्था मानना सही नहीं होगा।
इसका अर्थ यह नहीं है कि भारत में डीएनए जांच नहीं होती। भारत में केंद्रीय और राज्य फॉरेंसिक प्रयोगशालाओं में डीएनए परीक्षण होते हैं और जांच एजेंसियां अपराध, पितृत्व, मानव पहचान, लापता लोगों तथा अज्ञात शवों जैसे मामलों में डीएनए तकनीक का इस्तेमाल करती हैं। गृह मंत्रालय के अनुसार केंद्रीय फॉरेंसिक विज्ञान प्रयोगशालाओं में डीएनए जांच की सुविधाएं मौजूद हैं और राज्य फॉरेंसिक प्रयोगशालाओं की क्षमता भी मजबूत की गई है।
डीएनए टेस्ट हमेशा 100 प्रतिशत आसान क्यों नहीं होता?
फिल्मों में अक्सर डीएनए जांच को बेहद सीधी प्रक्रिया की तरह दिखाया जाता है। एक नमूना लिया, मशीन में डाला और कुछ मिनट बाद नाम सामने आ गया। वास्तविकता इससे कहीं ज्यादा जटिल है। अपराध स्थल का नमूना खराब हो सकता है। उसमें डीएनए की मात्रा बहुत कम हो सकती है। गर्मी, नमी और समय डीएनए को नुकसान पहुंचा सकते हैं। कभी-कभी एक ही नमूने में कई लोगों का डीएनए मिला होता है। ऐसे मामलों में प्रोफाइल को अलग करना और उसकी व्याख्या करना मुश्किल हो सकता है।
इसके अलावा किसी जगह से किसी व्यक्ति का डीएनए मिल जाना अपने आप यह साबित नहीं करता कि उसने अपराध किया। किसी व्यक्ति का डीएनए वहां किसी सामान्य संपर्क, पुराने संपर्क या किसी अन्य परिस्थिति के कारण भी पहुंच सकता है। इसलिए डीएनए को घटनास्थल, अन्य सबूतों और जांच की पूरी कहानी के साथ समझना जरूरी होता है।
डीएनए डेटाबैंक अपराध से आगे भी काम आता है
डीएनए डेटाबैंक की उपयोगिता केवल अपराधी खोजने तक सीमित नहीं है। अज्ञात शवों की पहचान और लापता लोगों को उनके परिवारों से जोड़ने में भी डीएनए महत्वपूर्ण भूमिका निभाता है। इसमें परिवार के सदस्यों के डीएनए नमूनों की तुलना अज्ञात व्यक्ति के डीएनए से की जा सकती है। ऐसा इसलिए संभव है क्योंकि माता-पिता, बच्चे और करीबी जैविक रिश्तेदारों के डीएनए में साझा आनुवंशिक पैटर्न होते हैं।
अमेरिका के डीएनए डेटा बेस में लापता लोगों के मामलों के लिए अलग तरह के प्रोफाइल भी रखे जाते हैं और परिवार के स्वैच्छिक संदर्भ नमूनों को अज्ञात मानव अवशेषों तथा लापता लोगों से जुड़े रिकॉर्ड के साथ मिलाया जा सकता है। भारत में भी बड़े हादसों और आपदाओं में परिवारों से संदर्भ नमूने लेकर डीएनए प्रोफाइलिंग की जाती है। गृह मंत्रालय ने 2026 में नेपाल में आई बाढ़ के संदर्भ में परिवार के संदर्भ नमूनों के संग्रह और डीएनए प्रोफाइलिंग से संबंधित जानकारी भी जारी की है।
असल में डीएनए डेटाबैंक क्या है?
इसे सबसे आसान तरीके से ऐसे समझ सकते हैं। डीएनए डेटाबैंक लोगों के पूरे डीएनए का गोदाम नहीं, बल्कि खास उद्देश्य के लिए तैयार की गई डीएनए प्रोफाइलों की खोज योग्य व्यवस्था है। प्रयोगशाला किसी नमूने से डीएनए निकालती है, चुने हुए हिस्सों की जांच करती है, उनसे एक प्रोफाइल बनाती है और जरूरत के अनुसार उसे संबंधित डेटाबैंक में खोजा जा सकता है। फिर कंप्यूटर बहुत बड़ी संख्या में प्रोफाइलों के बीच समानता खोजता है।
अगर कोई संभावित मैच मिलता है तो वैज्ञानिक उसकी पुष्टि करते हैं और जांच एजेंसी को सुराग मिलता है। यानी डीएनए टेस्ट की असली ताकत इस बात में नहीं है कि वैज्ञानिक आपके शरीर की हर आनुवंशिक जानकारी पढ़ लेते हैं। ताकत इस बात में है कि डीएनए के कुछ बेहद उपयोगी पहचान-चिह्नों को इतनी सटीकता से पढ़ा जा सकता है कि एक छोटा सा जैविक नमूना भी किसी व्यक्ति, किसी परिवार या कभी-कभी दो अलग-अलग अपराधों के बीच महत्वपूर्ण कड़ी बन सकता है। और यही कारण है कि 1990 के दशक में शुरू हुई डीएनए डेटाबैंक की व्यवस्था आज फॉरेंसिक विज्ञान का एक महत्वपूर्ण हिस्सा बन चुकी है।


